AI unleashed
I august var AI for mig autocomplete og et chatvindue, og jeg var ikke imponeret. Nu giver jeg planer til op til tredive agenter ad gangen, på en sammenlægning af backends, der ikke må have nedetid. Agenterne kan kun løbe frit, fordi planen er stram: om hvordan jeg beslutter, hvad jeg overlader, hvorfor et par timers planlægning er den dyre del, og hvad reviewet fangede, da agenterne skrev Java i Go.
Jeg var ikke vant til at arbejde med AI, da jeg startede hos GolfNext i august. Jeg havde brugt GitHub Copilot før, både autocomplete, der foreslår de næste par linjer, mens man skriver, og chatten, hvor man kan prompte den, og jeg var ikke imponeret. Den kunne ikke løse mine opgaver for mig. Dengang byggede jeg en integration mod et system, hvis dokumentation var privat, bag et login, og der var ingen måde at få Copilot til at læse den. Så uanset om den færdiggjorde en linje eller svarede på en prompt, arbejdede den mod et API, den aldrig havde set, og jeg lavede selv det egentlige arbejde.
Min chef sagde, at jeg ville blive imponeret af Claude Code. Jeg tænkte, at det ville jeg tro på, når jeg så det. Så så jeg det.
Claude Code er ikke autocomplete, og det er heller ikke et chatvindue. Det er en agent: man giver den en opgave, og den læser koden, kører kommandoer, laver ændringer og tjekker sit eget arbejde. Den kan endda bruge min browser, når jeg lader den, så dokumentation bag et login er noget, den kan gå ind og læse, på samme måde som jeg ville. Den mur, jeg ramte med Copilot, er der simpelthen ikke længere. I de to måneder siden har min måde at arbejde på flyttet sig. I dag ville jeg kalde det agentic engineering. Jeg bruger min tid på at beslutte, hvad der skal bygges, og på at tjekke, at det blev bygget, og agenterne står for det meste af byggeriet ind imellem.
Sådan ser det ud på det største, jeg arbejder på.
Vi har to adminportaler. Hver har sin egen backend, sit eget login og sin egen database, og klubpersonale, der bruger begge, logger ind to gange. At lægge dem sammen til én står på roadmappet, og jeg har skrevet før om den rækkefølge, vi valgte: først en bro mellem de to logins, så én frontend oven på begge backends, og til sidst selve backend-delene.
De to første trin er færdige. Frontenden fra den ene portal ligger nu inde i den anden, de to platforme taler sammen, og featureudviklingen fortsatte i begge hele vejen igennem. Ingen fik et servicevindue. Golfklubber kører på den her software hver dag, så der var ingen planlagt nedetid, og der kommer heller ingen i resten af forløbet.
Det næste trin er sværere. Den ene backend er skrevet i Java, og vi genopbygger den i Go. Når det er gjort, bliver den ene backend porteret ind i den anden, og vi ender med én samlet applikation. Igen uden at stoppe featureudviklingen, og igen uden et vindue.
Det meste af koden til det bliver ikke tastet af et menneske. Det er den del, folk spørger til, og det er den mindst interessante del. Den første beslutning om ethvert stykke arbejde er dets størrelse, for jeg bruger agenter på tre forskellige måder. Sammenlægningen af backends er det store tilfælde, og jeg når frem til det via de små og de mellemstore. Det, der ændrer sig mellem de tre, er, hvor meget af tænkningen jeg overlader, og hvornår jeg tager den tilbage.
Lille: kan du gøre det selv?
Ved en lille opgave stiller jeg agenten ét spørgsmål, før noget andet: kan du gøre det her selv?
Jeg siger ikke “gør det”. Jeg spørger, om den kan. Den læser koden, ser på, hvad opgaven berører, og fortæller mig, om den er sikker, eller om der er noget, den ikke ved. Det meste af tiden er svaret ja, og så gør den det. Nogle gange er svaret “det her afhænger af, hvordan X opfører sig, og det kan jeg ikke se herfra”, og det er præcis den sætning, jeg gerne vil høre, før den går i gang, og ikke bagefter.
Et typisk eksempel: en fejlrapport om en printer, der ikke printer. Softwaren vidste udmærket, at noget var gået galt, for den skrev fejlen i loggen. Den fortalte det bare aldrig til den person, der brugte den, som ikke fik nogen advarsel overhovedet og stod og ventede på en udskrift, der aldrig kom. Rettelsen er lille og klart afgrænset: find stedet, hvor fejlen bliver fanget, og vis den til brugeren i stedet for kun at logge den. Jeg stillede spørgsmålet, fik et ja, og agenten rettede den selv.
Spørgsmålet koster ingenting, og det ændrer måden, det kan gå galt på. En agent, der får besked på at gøre noget, gør noget. En agent, der bliver spurgt, om den kan, har lov til at sige nej.
Mellem: research først, muligheder bagefter
Ved en mellemstor opgave går agenten først, men den bygger ikke noget. Den vurderer opgaven, laver researchen (den involverede kode, API-dokumentationen, hvordan det samme problem allerede er løst andre steder i vores repositories) og kommer tilbage med, hvad den fandt, og hvad den vil foreslå.
Et typisk eksempel: et featureønske fra en klub, der bruger en bestemt integration. Agenten kan læse integrationen, se hvad den allerede understøtter, og finde ud af, hvor ønsket ville passe ind. Men den kommer tilbage med spørgsmål i stedet for et svar. Kan det overhovedet lade sig gøre med det, integrationen stiller til rådighed? Hvis ja, hvilken del af integrationen skal så udvides? Eller er den ene klubs behov så anderledes, at det fortjener sit eget specialmodul, frem for at bøje en fælles integration omkring det?
Det er ikke spørgsmål, koden kan svare på. De afhænger af, hvor mange andre klubber der bruger integrationen, hvad vi er villige til at vedligeholde, og hvor produktet er på vej hen, og intet af det står skrevet nogen steder, agenten kan læse. Så den kan ikke løse opgaven uden mig, og den skal ikke lade som om, den kan. Det, den kan, er at gøre et vagt ønske til en kort liste af reelle valg med fordele og ulemper allerede regnet igennem. Så begynder jeg at forme løsningen: jeg vælger én, kombinerer to, eller smider dem alle ud, fordi researchen ændrede spørgsmålet.
Stort: et par timer, før der skrives kode
Ved et stort projekt, og at lægge to backends sammen, mens begge bliver ved med at levere features, er et stort projekt, bruger jeg et par timer på at planlægge med agenten, før noget bliver bygget.
En del af det er brainstorm. Det meste er mig, der leverer den kontekst, agenten ikke selv kan få fat i:
- Arkitektur. Hvad taler med hvad, hvilke grænser skal holde, hvad er målbilledet, og hvilke kompromiser er tilladt på vejen derhen.
- Teknologi. Hvad vi standardiserer på, hvad vi bevæger os væk fra, og hvad der ikke er til diskussion.
- Formål. Hvorfor vi overhovedet gør det. Her: klubpersonale skal logge ind én gang, og vi skal vedligeholde ét system i stedet for to.
- Brugeroplevelse. Hvad personen i den anden ende ser under hvert trin af migreringen, også de trin, der kun er halvt færdige.
Planen begynder sit liv i agentens kontekst, den igangværende samtale, vi lige har brugt to timer på at fylde. Det er et skrøbeligt sted at opbevare noget. Luk sessionen, og den er væk, og ingen andre på teamet kan se den, mens den varer.
Så det sidste, planlægningssessionen gør, er at skrive den ud, som opgaver i vores opgavesystem frem for et langt dokument. Hver opgave får sine underopgaver, og agenten registrerer afhængighederne mellem dem: hvad der skal findes, før en opgave kan begynde, og hvad der venter på, at den bliver færdig. Når jeg lukker sessionen, er planen holdt op med at være en samtale og blevet til noget, resten af teamet kan se, tage fat i og følge.
Før noget går i gang, hører teamet om det. Vi taler det kort igennem, og de hører løsningsforslaget. De snakke er korte, for vi er allerede enige om det meste af retningen. Nogle gange beder jeg også en kollega om at kigge på selve planen for at få en second opinion, for en plan, som kun én person og én agent har set, har haft præcis ét menneskeligt tjek.
Det her er den dyre del, og det skal det være. Hvert spørgsmål, der bliver besvaret her, er et spørgsmål, en agent ikke skal gætte på senere. Hver afhængighed, der bliver skrevet ned, er en kollision, der ikke sker, når tredive ting kører på én gang.
Udførelsen er bevidst den kedelige del
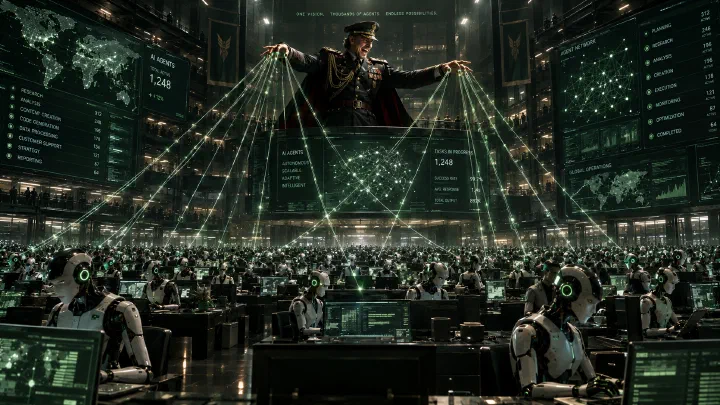
Når planen findes, er udførelsen næsten et antiklimaks. Jeg giver den tilbage til agenten, og den starter subagenter (separate agenter, den selv starter og koordinerer, hver med sin egen opgave) på hver underopgave, hvis afhængigheder er opfyldt. Som regel et sted mellem ti og tredive ad gangen. Når én bliver færdig, kan det, der ventede på den, gå i gang.
Tredive agenter i én kodebase lyder som en opskrift på, at de falder over hinanden. Det, der holder dem adskilt, er planen. De afhængigheder, der blev skrevet ned under planlægningen, afgør, hvad der kan køre samtidig, og hvad der må vente, så to agenter ikke ender med at bygge oven på noget, der ikke findes endnu.
Det virker, fordi der ikke er noget vigtigt tilbage, som agenterne skal beslutte. En agent, der kører en veldefineret underopgave med sin kontekst skrevet ned ved siden af, laver præcis den slags arbejde, agenter er gode til. En agent, der kører en vag opgave, gætter med stor selvsikkerhed, og man finder først ud af bagefter, hvilke dele der var gæt.
Det er også derfor, jeg ikke stoler på ordet “unleashed”, når folk bruger det om AI. Agenterne kan kun løbe frit, fordi planen er stram.
Byggede de det, jeg planlagde?
Når alle agenterne er færdige, tjekker jeg først, om de byggede det, jeg planlagde. Landede hver opgave faktisk, og hænger helheden sammen til det, vi designede, frem for en samling underopgaver, der hver især består deres egne tests?
Derefter reviewer jeg fra tre retninger:
- Arkitektur. Holdt grænserne? Krydsede noget en grænse, det ikke burde, eller tilføjede stille og roligt en afhængighed, planen ikke havde?
- Kodekvalitet. Er det kode, nogen på teamet kan eje om et år? I tråd med resten af repositoriet, testet hvor det betyder noget, ingen smarte detaljer, som ingen bad om.
- Brugeroplevelse. Føles det rigtigt for den, der bruger det, også midt i migreringen, hvor halvdelen af systemet er gammelt og halvdelen nyt?
To af dem, arkitektur og brugeroplevelse, er kontekst, jeg gav agenten fra starten, så reviewet tjekker i virkeligheden arbejdet mod det, jeg leverede. Hvis det bliver ved med at finde den samme slags problem, hører rettelsen som regel hjemme i den næste plan.
Den tydeligste fangst indtil videre kom fra selve backend-omskrivningen, en portering fra Java til Go. På papiret leverede agenterne det, der var planlagt: endpoints var der og gjorde det samme som de gamle. Men den første version var Java skrevet i Go. Hvor Java-koden lænede sig op ad et bibliotek, genopbyggede agenterne det bibliotek i Go i hånden, også når Gos eget standardbibliotek allerede klarede opgaven. Datoer var det oplagte eksempel. I stedet for at bruge Gos time-pakke, som håndterer dem helt fint, fik vi en hjemmelavet kopi af den måde, Java håndterer dato og tid på.
Intet af det får en test til at fejle. Det kompilerer, det kører, det giver de rigtige svar. Det er også kode, som ingen på teamet burde skulle vedligeholde: mere af den end nødvendigt, formet som et sprog, den ikke er skrevet i, og fremmed for enhver, der kender Go. Det er et kodekvalitetsproblem og et arkitekturproblem på én gang, og man fanger det kun ved at spørge “er det sådan, vi ville bygge det?” og ikke kun “virker det?”.
Rettelsen gik gennem det samme loop som alt andet. Jeg spurgte Claude, hvordan vi kunne slippe af med det hjemmelavede bibliotek og bruge Gos standardbibliotek i stedet, uden at miste noget. Den sidste del var den egentlige begrænsning. Klienter kalder allerede de endpoints, og hvert tidsstempel, de får tilbage, skal komme ud i præcis samme format efter porteringen som før. En portering, der er pænere indeni og ødelægger nogens datoparsing udenpå, er ikke færdig. Det blev rettet: det hjemmelavede bibliotek forsvandt, og tidsstemplerne forblev de samme.
Hvor min tid blev af
Læg det sammen, og på et stort projekt er tastearbejdet næsten forsvundet fra min dag. Tilbage er de to ender: timers planlægning i starten og et grundigt review til sidst. Det er et andet arbejde, og der er ikke mindre af det. Men jeg får langt mere fra hånden.
Jeg tror, det er den rigtige måde at se AI-kodning på: som en compiler, ikke som noget, der er ude efter vores job. Ingen skriver maskinkode i hånden længere. Compileren overtog det for årtier siden, og den gjorde ikke programmører overflødige. Den flyttede arbejdet et niveau op, til at beslutte, hvad programmet skal gøre. Agenter er det næste trin op, med én stor forskel: en compiler gætter ikke. Derfor er reviewet til sidst ikke valgfrit.
Indtil videre, her hos os, er produktiviteten ikke blevet til færre mennesker. Den er blevet til større ambitioner. Ethvert team har en liste over ting, der klart er værd at lave, men som aldrig vinder over den næste kundeforespørgsel: bedre interne værktøjer, features kunderne ville sætte pris på, men aldrig bad højlydt om, nemmere onboarding af den næste, der starter. Nu har vi tid til dem.
I august var AI for mig autocomplete og et chatvindue, og jeg var ikke imponeret. To måneder senere planlægger jeg sammenlægningen af to backends, der ikke må tages ned, og giver planen til 10, 20 eller 30 agenter ad gangen.
Min chef havde ret. Jeg blev imponeret. Men det var ikke hastigheden på tastearbejdet, der imponerede mig. Det var at opdage, at når tastearbejdet holder op med at være jobbet, så er det, der er tilbage, planen og reviewet, den del, jeg altid hellere ville have lavet.